西维蜀黍

【Python】Python 几种常用的测试框架

常见的测试框架

1 Unittest

unittest是Python内置的标准类库。它的API跟Java的JUnit、.net的NUnit,C++的CppUnit很相似。

通过继承unittest.TestCase来创建一个测试用例。

具体请参考文档。

举个例:

import unittest

def fun(x):
    return x + 1

class MyTest(unittest.TestCase):
    def test(self):
        self.assertEqual(fun(3), 4)
  ...


【Distributed System】高并发(High Concurrency)

Design Levels

Consistency Models

Scalability

  • vertical scalability
  • horizential scalability
  ...


【Architecture】中台概念

中台

提到中台,最常听到的一个词就是「能力」。可能是因为能力这个词足够简单,又有着足够的包容度与宽度。

企业的能力可能包含多个维度,常见的例如计算能力,技术能力,业务能力,数据能力,AI能力,运营能力,研发能力……其中大部分的能力还可以继续细化和二次展开,从而形成一张多维度的企业能力网。

可以说,中台就是企业所有可以被「多前台产品团队」复用能力的载体。

根据中台的类型,可以分为以下几种:

  • 数据中台
  • 业务中台
    • 中台就是微服务业务平台,像最常见的用户中心,订单中心,人们都叫它“业务中台”。
  • 技术中台
    • 中台就是技术平台,像微服务开发框架、Devops平台、PaaS平台,容器云之类的,人们都叫它“技术中台”。
  • 组织中台
    • 中台应该是组织的事情,在释放潜能:类似于企业内部资源调度中心和内部创新孵化组织,人们叫它**“组织中台”**。
  ...


【Algorithm】算法思想 - 分治算法(Divide and Conquer)

分治算法

基本概念

在计算机科学中,分治法是一种很重要的算法。字面上的解释是“分而治之”,就是把一个复杂的问题分成两个或更多的相同或相似的子问题,再把子问题分成更小的子问题……直到最后子问题可以简单的直接求解,原问题的解即子问题的解的合并。这个技巧是很多高效算法的基础,如排序算法(快速排序,归并排序),傅立叶变换(快速傅立叶变换)……

任何一个可以用计算机求解的问题所需的计算时间都与其规模有关。问题的规模越小,越容易直接求解,解题所需的计算时间也越少。例如,对于n个元素的排序问题,当n=1时,不需任何计算。n=2时,只要作一次比较即可排好序。n=3时只要作3次比较即可,…。而当n较大时,问题就不那么容易处理了。要想直接解决一个规模较大的问题,有时是相当困难的。

基本思想及策略

分治法的设计思想是:将一个难以直接解决的大问题,分割成一些规模较小的相同问题,以便各个击破,分而治之。

分治策略是:对于一个规模为n的问题,若该问题可以容易地解决(比如说规模n较小)则直接解决,否则将其分解为k个规模较小的子问题,这些子问题互相独立且与原问题形式相同,递归地解这些子问题,然后将各子问题的解合并得到原问题的解。这种算法设计策略叫做分治法。

如果原问题可分割成k个子问题,1<k≤n,且这些子问题都可解并可利用这些子问题的解求出原问题的解,那么这种分治法就是可行的。由分治法产生的子问题往往是原问题的较小模式,这就为使用递归技术提供了方便。在这种情况下,反复应用分治手段,可以使子问题与原问题类型一致而其规模却不断缩小,最终使子问题缩小到很容易直接求出其解。这自然导致递归过程的产生。分治与递归像一对孪生兄弟,经常同时应用在算法设计之中,并由此产生许多高效算法。

  ...


【Algorithm】算法思想 - 贪心算法(Greedy Algorithm)

贪心算法(Greedy Algorithm)

贪心算法(Greedy Algorithm),又称贪婪算法,是一种在每一步选择中都采取在当前状态下最好或最优(即最有利)的选择,从而希望导致结果是最好或最优的算法。比如在旅行推销员问题中,如果旅行员每次都选择最近的城市,那这就是一种贪心算法。

贪心算法在有最优子结构的问题中尤为有效。最优子结构的意思是局部最优解能决定全局最优解。简单地说,问题能够分解成子问题来解决,子问题的最优解能递推到最终问题的最优解。

贪心算法与动态规划的不同在于它对每个子问题的解决方案都做出选择,不能回退。动态规划则会保存以前的运算结果,并根据以前的结果对当前进行选择,有回退功能。

我们能够依据贪心法的2个重要的性质去证明:贪心选择性质和最优子结构性质。

贪心选择

什么叫贪心选择?从字义上就是贪心也就是目光短线。贪图眼前利益。在算法中就是仅仅依据当前已有的信息就做出选择,并且以后都不会改变这次选择**(这是和动态规划法的主要差别)**。

所以对于一个具体的问题。要确定它是否具有贪心选择性质,必须证明每做一步贪心选择是否终于导致问题的总体最优解。

最优子结构

当一个问题的最优解包括其子问题的最优解时,称此问题具有最优子结构性质。

运用贪心策略在每一次转化时都取得了最优解。问题的最优子结构性质是该问题可用贪心算法或动态规划算法求解的关键特征。贪心算法的每一次操作都对结果产生直接影响,而动态规划则不是。贪心算法对每个子问题的解决方案都做出选择,不能回退;动态规划则会根据以前的选择结果对当前进行选择,有回退功能。动态规划主要运用于二维或三维问题,而贪心一般是一维问题。

基本思路

贪心算法的基本思路是从问题的某一个初始解触发一步一步地进行,根据抹个优化测度,每一步都要确保能获得局部最优解,每一步值考虑一个数据,他的选取应该满足局部优化的条件。若下一个数据和部分最优解连载一起不再是可行解时,就不把改数据添加到部分解中,知道把所有数据枚举玩,或者不能在添加算法停止。

过程

  1. 建立数学模型来描述问题;
  2. 把求解的问题分成若干个子问题;
  3. 对每一子问题求解,得到子问题的局部最优解;
  4. 把子问题的解局部最优解合成原来解问题的一个解。
  ...


【Algorithm】排序算法 - 计数排序(Counting Sort)

计数排序(Counting Sort)

计数排序是一种非基于比较的排序算法,计数排序的时间复杂度为 O(n + m),m 指的是数据量,说的简单点,计数排序算法的时间复杂度约等于 O(n),快于任何比较型的排序算法。

图解计数

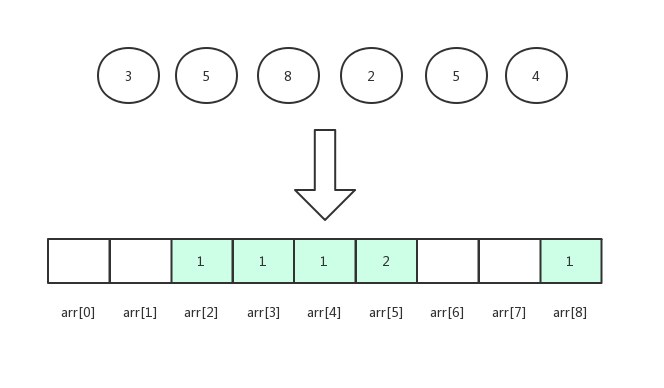
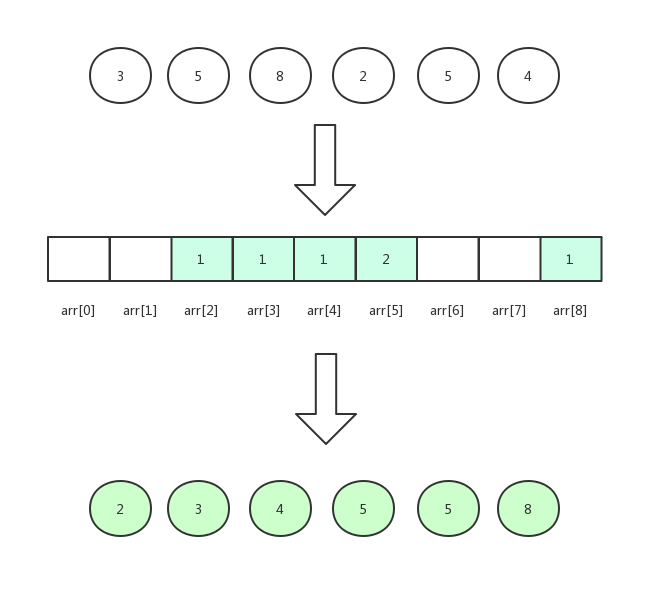
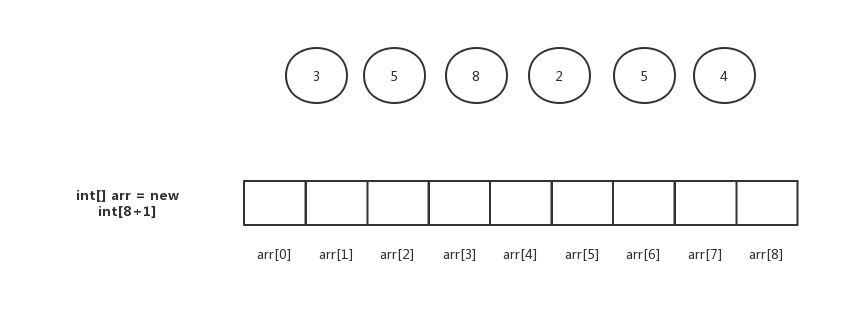
以下以[ 3,5,8,2,5,4 ]这组数字来演示。

首先,我们找到这组数字中最大的数,也就是 8,我们就创建一个最大下标为 8 的空数组 arr 。

遍历数据,以将数据的出现次数填入arr中对应的下标位置中(该数据的值等于arr中对应的下标)。

遍历 arr ,将数据依次取出即可。

  ...


【Architecture】系统架构考虑

技术选型

技术栈

从前端到后端,从缓存到数据库

前端

  • 前端框架
    • Angular
    • React
  • 前端页面选择模板引擎还是动静分离?

后端中间层 - 是否需要 Node.js

后端

  • 服务端选择Java还是Node.js?
  • 服务治理选择DubboX还是Spring Cloud?
  • 是否需要使用
  • 消息队列选择RocketMQ还是Kafka?
  • 数据库选择MySQL 还是Oracle?
  • 是否需要缓存 - 缓存选择Redis Cluster 还是 Codis?
  • 全文检索选择Solr还是ES?
  ...


【Distributed System】SOA 与 MicroServices

要知道,我们对 SOA 概念的理解其实是在不断的变化。

SOA(Service Oriented Architecture,服务导向架构)

从最初的 SOA 概念来说,SOA 主要为了解决一个大系统中不同子系统的相互操作性(interopearability),即为了实现这个大系统,我们希望能够复用已经存在或者说已经开发好的小系统(它们可能基于不同的编程语言,甚至运行在不同的操作系统下)。因此,这也可以描述为系统的集成(integration)问题。

因此,在那时候,我们有了 ESB (Enterprise Service Bus,企业服务总线)、WSDL、BPEL 和 SOAP 等等这些概念。它们都是为了解决系统的集成问题而诞生的。

企业服务总线(Enterprise Service Bus,ESB)

**企业服务总线(Enterprise Service Bus,ESB)**的概念是从服务导向架构(Service Oriented Architecture, SOA)发展而来。SOA描述了一种IT基础设施的应用集成模型;其中的软构件集是以一种定义清晰的层次化结构来相互耦合。一个ESB是一个预先组装的SOA实现,它包含了实现SOA分层目标所必需的基础功能部件。

在企业计算领域,企业服务总线是指由中间件基础设施产品技术实现的、 通过事件驱动和基于XML消息引擎,为更复杂的面向服务的架构提供的软件架构的构造物。企业服务总线通常在企业消息系统上提供一个抽象层,使得集成架构师能够不用编码而是利用消息的价值完成集成工作。

需要明确的是,企业服务总线本质上解决的是一个大系统的集成问题,或者说这个大系统中不同子系统之间相互依赖的问题。

场景

Background

假设一下你通过银行前端的应用登入银行,会发生什么呢?

  1. 会显示你的名字
  2. 会显示你的账号余额
  3. 会展示你的信用卡和借记卡
  4. 会列出你的共同基金
  5. 会列出一些你可能感兴趣的,预先被计算好的,有吸引力收益的借贷产品

现在,很可能所有这些模块都来自于不同的系统和应用,通过各种接口把数据展示出来

  1. 是来自在linux和Oracle的CRM系统
  2. 是来自z/OS大型机的COBOL系统
  3. 据说是来自大型机,但是他们的嘴巴很紧,不肯告诉你任何事情,只提供CSV文件。
  4. 来自跑在Windows的混合着PHP和Ruby
  5. 来自Postgresql,Python和Java,跑在Linux和Solaris的

在下图,每条不同宽度或者样式的线表示了app之间的调用

如果你觉得上面这种情况你还可以勉强维护,那下面这种情况呢?

你可以处理400个吗?2000个怎么样?每个应用都有自己独特的生态系统,都需要用10个物理服务器或者设备跑在上面。所以,就好比有2万个移动的群体散落在大陆上,并且有着各自的技术的或者文化的边界。 所有这些群体彼此之间需要不断的,持续的交换信息,聊天,一刻也停不下来。

对这种情况,有个很好的名字,叫一团糟。

  ...

【Docker】减小 Docker 镜像体积

Problem

在构建 Docker 容器时,应该尽量想办法获得体积更小的镜像,因为传输和部署体积较小的镜像速度更快。

但 RUN 语句总是会创建一个新层,而且在生成镜像之前还需要使用很多中间文件,在这种情况下,该如何获得体积更小的镜像呢?

  ...


【Performance】性能指标(Performance Indicator)

Aspects of performance

Computer performance metrics (things to measure) include availability, response time, channel capacity, latency, completion time, service time, bandwidth, throughput, relative efficiency, scalability, performance per watt, compression ratio, instruction path length and speed up. CPU benchmarks are available.

Availability

Availability of a system is typically measured as a factor of its reliability - as reliability increases, so does availability (that is, less downtime). Availability of a system may also be increased by the strategy of focusing on increasing testability and maintainability and not on reliability. Improving maintainability is generally easier than reliability. Maintainability estimates (Repair rates) are also generally more accurate. However, because the uncertainties in the reliability estimates are in most cases very large, it is likely to dominate the availability (prediction uncertainty) problem, even while maintainability levels are very high.

  ...