西维蜀黍

【Java】集合类 - Queue - PriorityQueue类(优先队列)

PriorityQueue类

PriorityQueue 类在 Java 1.5 中引入。

PriorityQueue 是基于优先堆的一个无界队列,这个优先队列中的元素可以默认自然排序或者通过提供的 Comparator 在队列实例化的时排序。

默认情况下,为最小堆(这意味着,通过 queue.poll() 方法获取的第一个元素为队列中的最小值)。

PriorityQueue 不允许空值,而且不支持 non-comparable(不可比较)的对象,比如用户自定义的类。优先队列要求使用 Java Comparable 和 Comparator 接口给对象排序,并且在排序时会按照优先级处理其中的元素。

PriorityQueue 的大小是不受限制的,但在创建时可以指定初始大小。当我们向优先队列增加元素的时候,队列大小会自动增加。

PriorityQueue 是非线程安全的,所以 Java 提供了 PriorityBlockingQueue(实现 BlockingQueue接口)用于Java 多线程环境。

  ...


【Linux】命令 - sed

Usage

usage: sed script [-Ealn] [-i extension] [file ...]
       sed [-Ealn] [-i extension] [-e script] ... [-f script_file] ... [file ...]
  • -i:直接修改文件内容

    # 将 pets.txt 文件中所有 abc 替换成 123 并写回原文件中
    $ sed -i "s/abc/123/g" pets.txt
    

开头 s - 替换匹配字符串

我使用下面的这段文本做演示:

$ cat pets.txt
This is my cat
  my cat's name is betty
This is my dog
  my dog's name is frank
This is my fish
  my fish's name is george
This is my goat
  my goat's name is adam

把其中的 my 字符串替换成 Wei’s,下面的语句应该很好理解

  • s 表示替换命令
  • /my/ 表示匹配my
  • /Wei’s/ 表示把匹配字符串替换成 Wei’s
  • /g 表示把一行中所有的匹配字符串都进行替换,如果没有 g 则只有每行第一个匹配的 my 被替换成 Wei’s
$ sed "s/my/Wei's/g" pets.txt
This is Wei's cat
  Wei's cat's name is betty
This is Wei's dog
  Wei's dog's name is frank
This is Wei's fish
  Wei's fish's name is george
This is Wei's goat
  Wei's goat's name is adam

注意:如果你要使用单引号,那么你没办法通过 \这样来转义。因此,用双引号就可以了,因为,在双引号内可以用 \” 来实现对双引号的转义。

  ...


【Linux】命令 - lsof

lsof命令是什么

lsof lists on its standard output file information about files opened by processes

被打开的文件可以是

  • regular file
  • directory
  • 网络文件系统的文件
  • 字符设备文件
  • (函数)共享库
  • 管道,命名管道
  • 符号链接
  • a stream or a network file (Internet socket, NFS file or UNIX domain socket.
  ...


【Distributed System】云计算(Cloud Computing)

云计算(Cloud Computing)

我们对于云计算的概念,维基百科有以下定义:Cloud computing is a new form of Internet-based computing that provides shared computer processing resources and data to computers and other devices on demand.

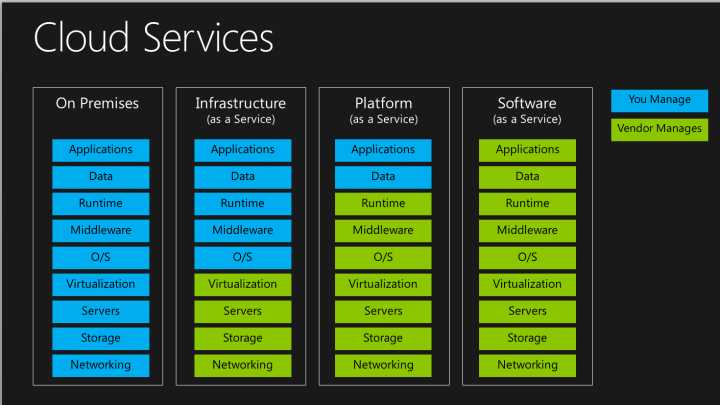
云计算就是一种按照需求通过Internet获取计算资源的形态。这些计算资源被包装成为服务,提供给用户。而提供这些服务的主体,我们称之为云服务供应商(Cloud Service Provider)。

按照NIST (National Institute of Standards and Technology,美国国家标准和技术研究院)的定义,云服务最主要的有三类:IaaS、PaaS、SaaS。

  ...


【Data Structure】树 - 平衡二叉查找树(Balanced Binary Search Tree) - 有了二叉查找树、AVL 树为啥还需要红黑树?

二叉查找树的缺点

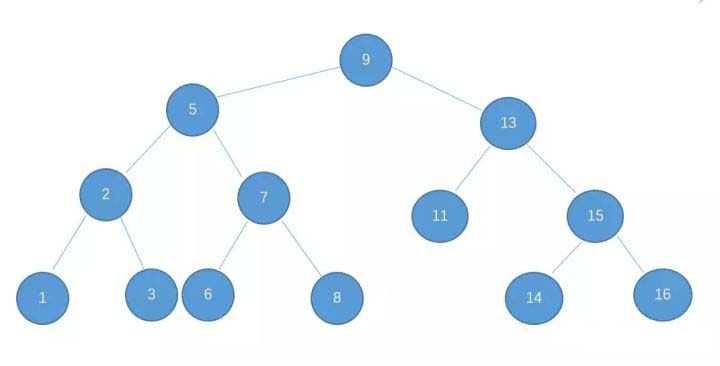
二叉查找树,相信大家都接触过,二叉查找树的特点就是左子树的节点值比父亲节点小,而右子树的节点值比父亲节点大,如图:

基于二叉查找树的这种特点,我们在查找某个节点的时候,可以采取类似于二分查找的思想,快速找到某个节点。n 个节点的二叉查找树,正常的情况下,查找的时间复杂度为 $O(log_2n)$。

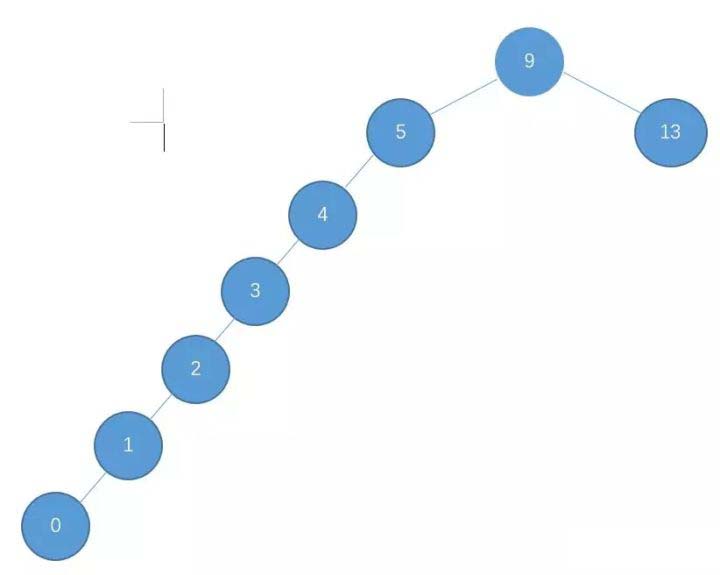
之所以说是正常情况下,是因为二叉查找树有可能出现一种极端的情况,例如

这种情况也是满足二叉查找树的条件,然而,此时的二叉查找树已经近似退化为一条链表,这样的二叉查找树的查找时间复杂度顿时变成了 O(n),可想而知,我们必须不能让这种情况发生,为了解决这个问题,于是我们引申出了平衡二叉树。

  ...


【Microservices】微服务架构(Microservice Architecture)

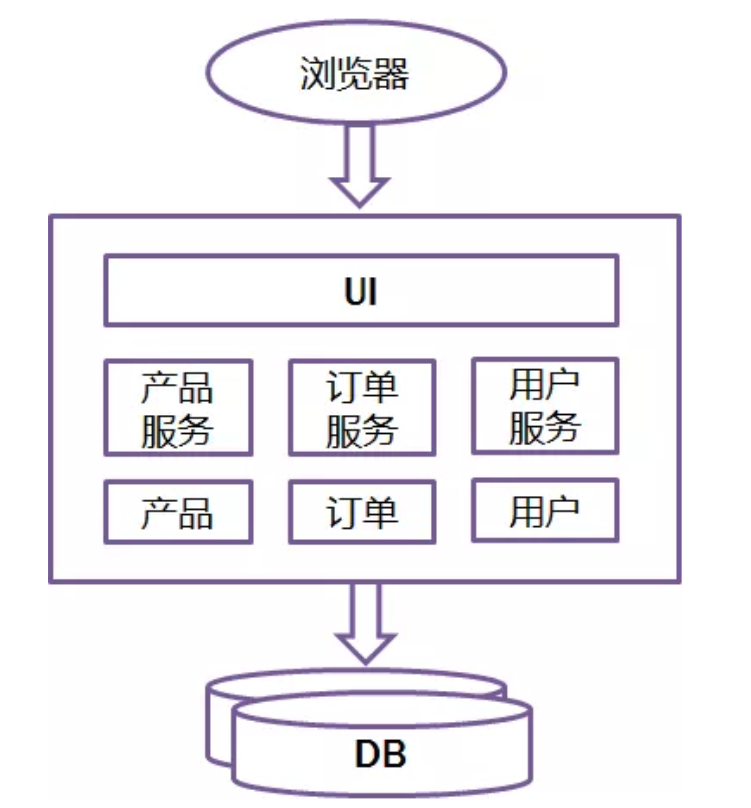
Monolithic Architecture

To start explaining the microservice style it’s useful to compare it to the monolithic style: a monolithic application built as a single unit. Enterprise Applications are often built in three main parts: a client-side user interface (consisting of HTML pages and javascript running in a browser on the user’s machine) a database (consisting of many tables inserted into a common, and usually relational, database management system), and a server-side application. The server-side application will handle HTTP requests, execute domain logic, retrieve and update data from the database, and select and populate HTML views to be sent to the browser. This server-side application is a monolith - a single logical executable. Any changes to the system involve building and deploying a new version of the server-side application.

Such a monolithic server is a natural way to approach building such a system. All your logic for handling a request runs in a single process, allowing you to use the basic features of your language to divide up the application into classes, functions, and namespaces. With some care, you can run and test the application on a developer’s laptop, and use a deployment pipeline to ensure that changes are properly tested and deployed into production. You can horizontally scale the monolith by running many instances behind a load-balancer.

以Java为例,所有的功能打包在一个 WAR包里,基本没有外部依赖(除了容器),部署在一个JEE容器(Tomcat,JBoss,WebLogic)里,包含了 DO/DAO,Service,UI等所有逻辑。
  ...

【Database】读写分离(Read/Write Splitting)

读写分离(Read/Write Splitting)+ 主从复制(Master-slave Replication)

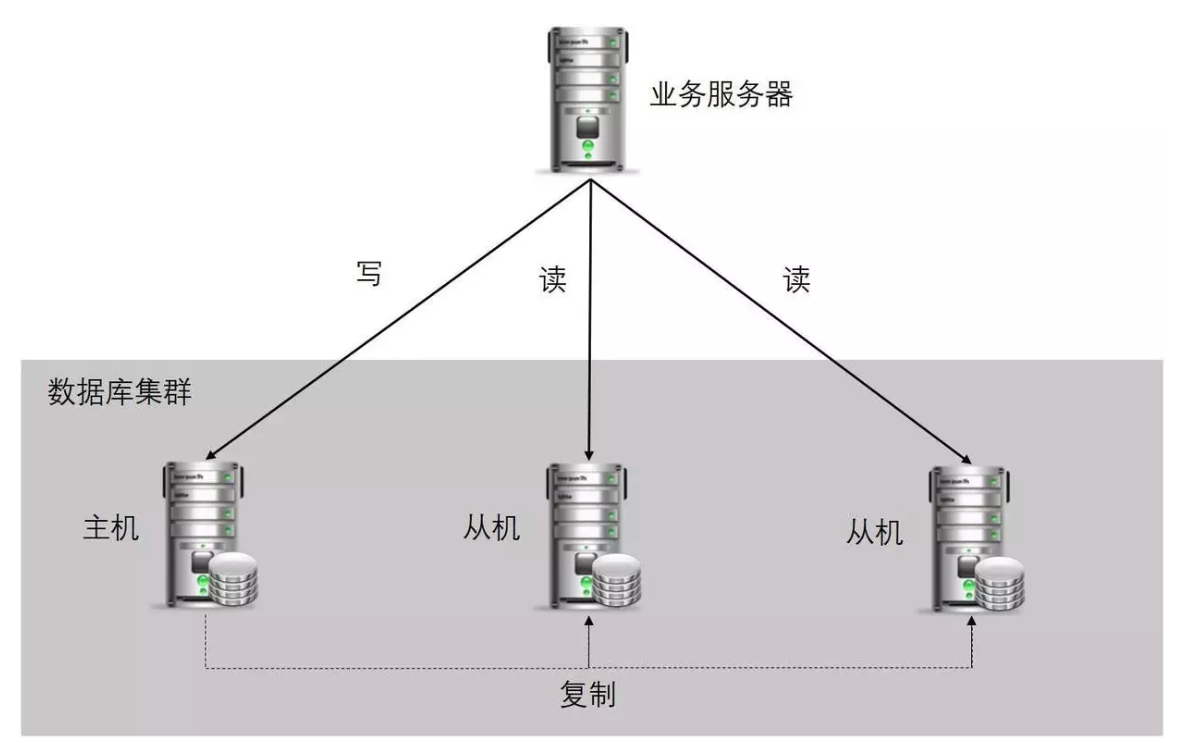
**读写分离(Read/Write Splitting)**的基本思想:让集群中的主数据库负责增(insert)、删(delete)和改(update)事务操作,而集群中的从数据库负责查询操作(select);并且,数据库后台会自动将因在主数据库中进行的事务操作导致的数据变更,同步到集群中的各个从数据库中。

MySQL的主从复制和MySQL的读写分离两者有着紧密联系,首先部署主从复制,只有主从复制完了,才能在此基础上进行数据的读写分离。简单来说,读写分离就是只在主服务器上写,只在从服务器上读,基本的原理是让主数据库处理事务性查询,而从数据库处理select查询。当业务量非常大时,一台服务器的性能无法满足需求,就可以通过配置主从复制实现写分离来分摊负载,避免因负载太高而造成无法及时响应请求。

读写分离的方式,扩展了数据库对读数据的处理能力,但写能力并没有任何提升。

而且,数据库中单表的数据量是有限制的,当数据库中单表的数据量到达一定程度后,数据库的性能会显著下降。

使用原因

大部分互联网业务读多写少,数据库的读往往最先成为性能瓶颈,如果希望:

  • 线性提升数据库读性能
  • 通过消除读写锁冲突提升数据库写性能

此时可以使用分组架构。

一句话,分组主要解决“数据库读性能瓶颈”问题,在数据库扛不住读的时候,通常读写分离,通过增加从库线性提升系统读性能。

适用场景

读写分离适用与读远大于写的场景,如果只有一台服务器,当select很多时,update和delete会被这些select阻塞,因此并发性能不高。 对于写和读比例相近的应用,应该部署双主相互复制。

  ...


【Data Structure】优先队列(Priority Queue)

Background

队列(Queue)

队列的特点是什么?

聪明的小伙伴们都知道,是先进先出(FIFO)。

  ...


【Algorithm】排序算法 - 桶排序(Bucket Sort)

Idea

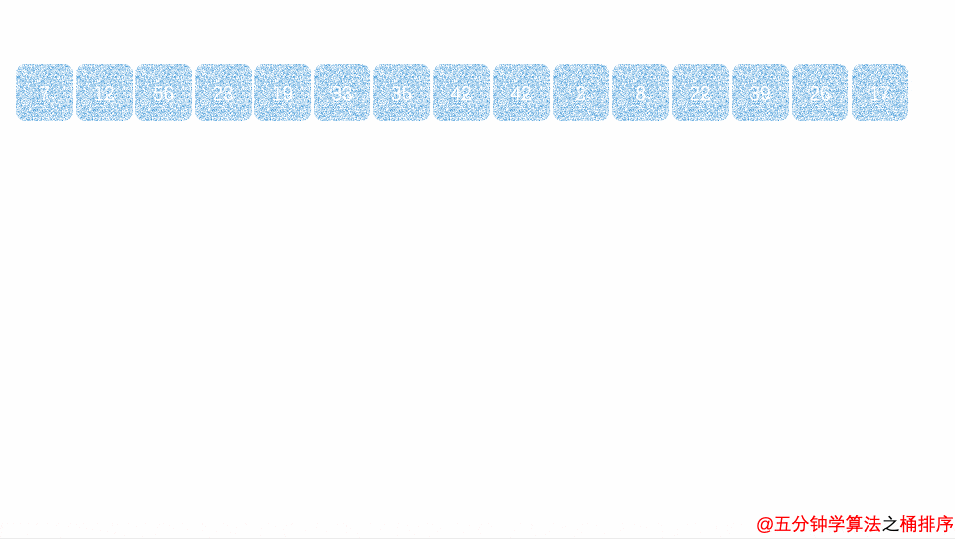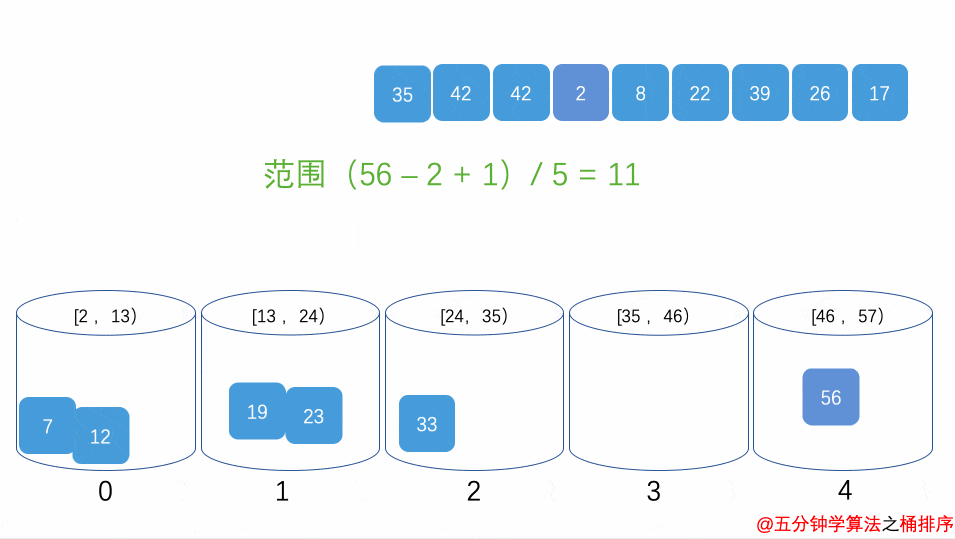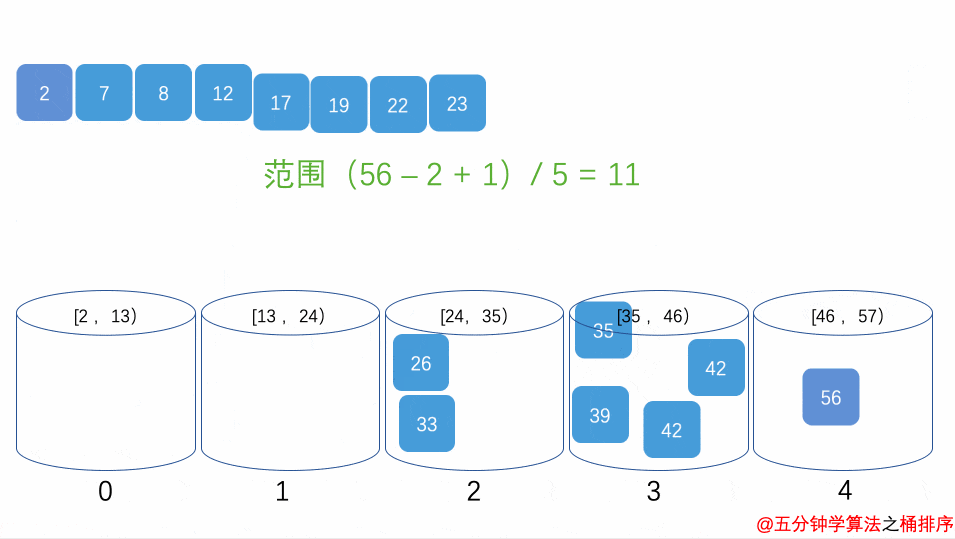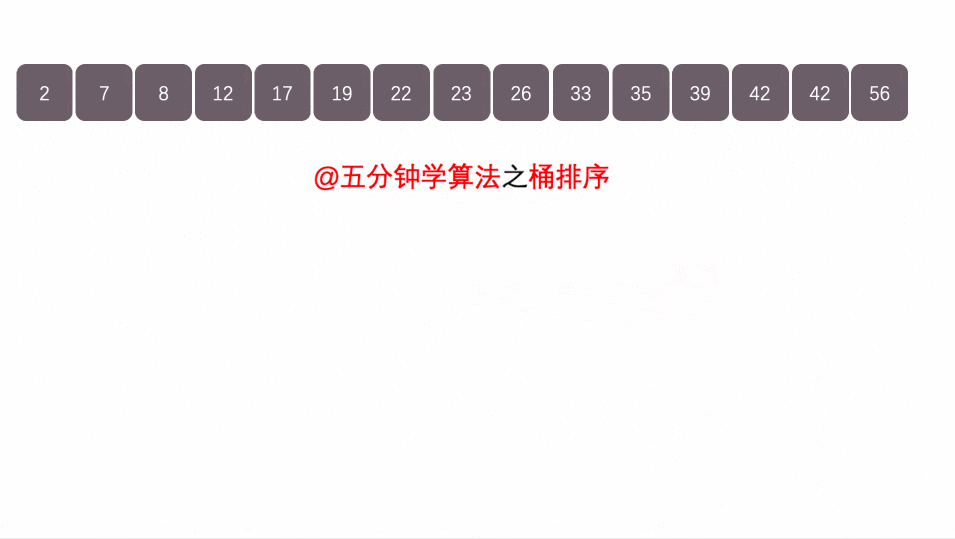
Bucket sort, or bin sort, is a sorting algorithm that works by distributing the elements of an array into a number of buckets. Each bucket is then sorted individually, either using a different sorting algorithm, or by recursively applying the bucket sorting algorithm.

思路

  1. 设置固定空桶数
  2. 将数据放到对应的空桶中
  3. 将每个不为空的桶进行排序
  4. 拼接不为空的桶中的数据,得到结果

步骤演示

假设一组数据(长度为20)为

[63,157,189,51,101,47,141,121,157,156,194,117,98,139,67,133,181,13,28,109] 

现在需要按5个分桶,进行桶排序,实现步骤如下:

  1. 找到数组中的最大值194和最小值13,然后根据桶数为5,计算出每个桶中的数据范围为(194-13+1)/5=36.4;
  2. 遍历原始数据,以第一个数据63为例,先找到该数据对应的桶序列(Math.floor(63 - 13) / 36.4) =1),然后将该数据放入序列为1的桶中(从0开始算);
  3. 当向同一个桶中第二次插入数据时,判断桶中已存在的数字与新插入的数字的大小,按从左到右,从小打大的顺序插入。如第一个桶已经有了63,再插入51,67后,桶中的排序为(51,63,67) ,一般通过链表来存放桶中数据。
  4. 全部数据装桶完毕后,按序列,从小到大合并所有非空的桶(0,1,2,3,4桶)
  5. 合并完之后就是排序好的数据了
  ...


【Algorithm】TopK 问题

有1亿个浮点数,如果找出期中最大的10000个?

排序

最容易想到的方法是将数据全部排序,然后在排序后的集合中进行查找,最快的排序算法的时间复杂度一般为O(nlogn),如快速排序。

但是在32位的机器上,每个float类型占4个字节,1亿个浮点数就要占用400MB的存储空间,对于一些可用内存小于400M的计算机而言,很显然是不能一次将全部数据读入内存进行排序的。其实即使内存能够满足要求(我机器内存都是8GB),该方法也并不高效,因为题目的目的是寻找出最大的10000个数即可,而排序却是将所有的元素都排序了,做了很多的无用功。

局部淘汰法

第二种方法为局部淘汰法,该方法与排序方法类似,用一个容器保存前10000个数,然后将剩余的所有数字——与容器内的最小数字相比,如果所有后续的元素都比容器内的10000个数还小,那么容器内这个10000个数就是最大10000个数。

如果某一后续元素比容器内最小数字大,则删掉容器内最小元素,并将该元素插入容器,最后遍历完这1亿个数,得到的结果容器中保存的数即为最终结果了。此时的时间复杂度为$O(n+m^2)$,其中m为容器的大小,即10000。

分治法

第三种方法是分治法,将1亿个数据分成100份,每份100万个数据,找到每份数据中最大的10000个,最后在剩下的100*10000个数据里面找出最大的10000个。

如果100万数据选择足够理想,那么可以过滤掉1亿数据里面99%的数据。100万个数据里面查找最大的10000个数据的方法如下:用快速排序的方法,将数据分为2堆,如果大的那堆个数N大于10000个,继续对大堆快速排序一次分成2堆,如果大的那堆个数N大于10000个,继续对大堆快速排序一次分成2堆,如果大堆个数N小于10000个,就在小的那堆里面快速排序一次,找第10000-n大的数字;递归以上过程,就可以找到第1w大的数。参考上面的找出第1w大数字,就可以类似的方法找到前10000大数字了。此种方法需要每次的内存空间为10^6*4=4MB,一共需要101次这样的比较。

  ...