西维蜀黍

【Algorithm】排序(Sorting)算法

排序算法的比较

算法 平均时间复杂度 最好时间复杂度 最坏时间复杂度 空间复杂度 排序方式 稳定性 备注
冒泡排序 $O(N^2)$ $O(N)$ $O(N^2)$ $O(1)$ In-place 稳定
选择排序 $O(N^2)$ $O(N^2)$ $O(N^2)$ $O(1)$ In-place 稳定
插入排序 $O(N^2)$ $O(N)$ $O(N^2)$ $O(1)$ In-place 稳定 时间复杂度和初始顺序有关
希尔排序(Shell Sort) $O(Nlog_2N)$ $O(Nlog_2N)$ $$O(N^2)$ $O(1)$ In-place 不稳定 改进版插入排序
归并排序(Merge Sort) $O(Nlog_2N)$ $O(Nlog_2N)$ $O(Nlog_2N)$ $O(N)$ Out-place 不稳定
快速排序 $O(Nlog_2N)$ $O(Nlog_2N)$ $O(N^2)$ $O(1)$ In-place 不稳定
堆排序(Heap Sort) $O(Nlog_2N)$ $O(Nlog_2N)$ $O(Nlog_2N)$ $O(1)$ In-place 不稳定
桶排序 (bucke sort) O(N) O(N) $O(N^2)$ or $O(Nlog_2N)$ $O(N)$ Out-place 稳定 最坏时间复杂度取决于对于桶内元素进行排序的算法
  ...


【Algorithm】排序算法 - 冒泡排序(Bubble Sort)

冒泡排序(Bubble Sort)

**冒泡排序(Bubble Sort)**是一种简单的排序算法。它重复地走访过要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行,直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
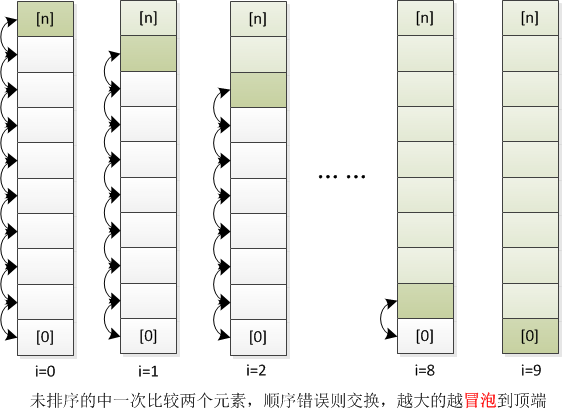
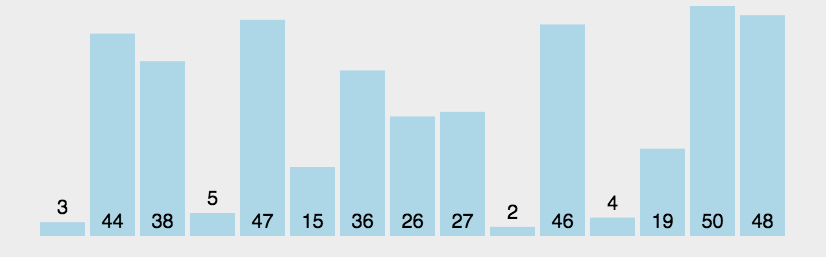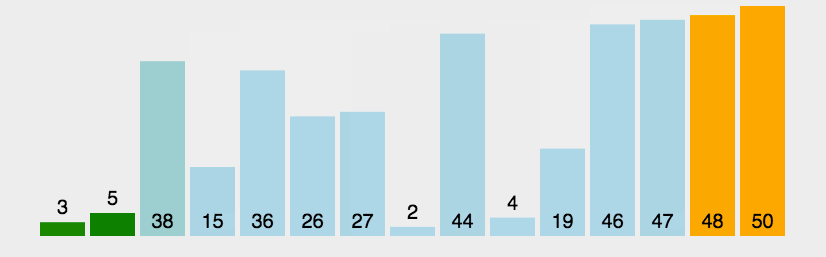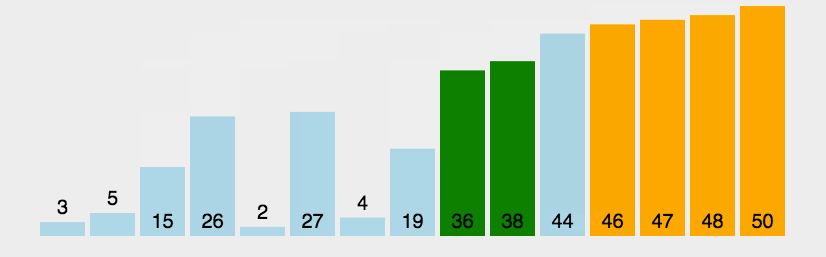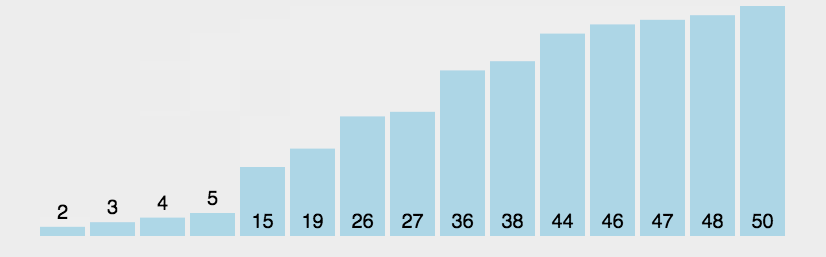
图解冒泡

第一轮冒泡

以 [ 8,2,5,9,7 ] 这组数字来做示例。

从左往右依次冒泡,将小的元素往右冒泡(移动):
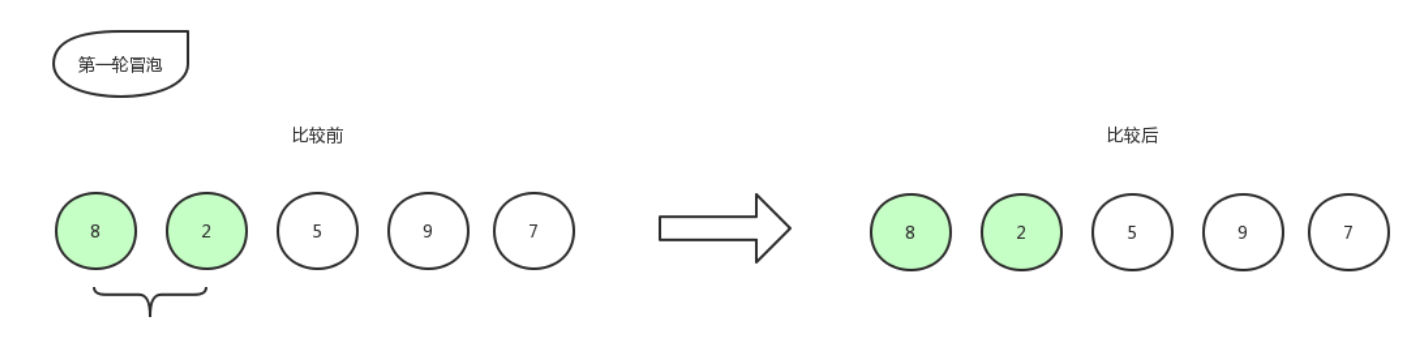
首先比较第一个数和第二个数的大小,我们发现 2 比 8 要小,那么保持原位,不做改动。位置还是 8,2,5,9,7 。

指针往右移动一格,接着比较:
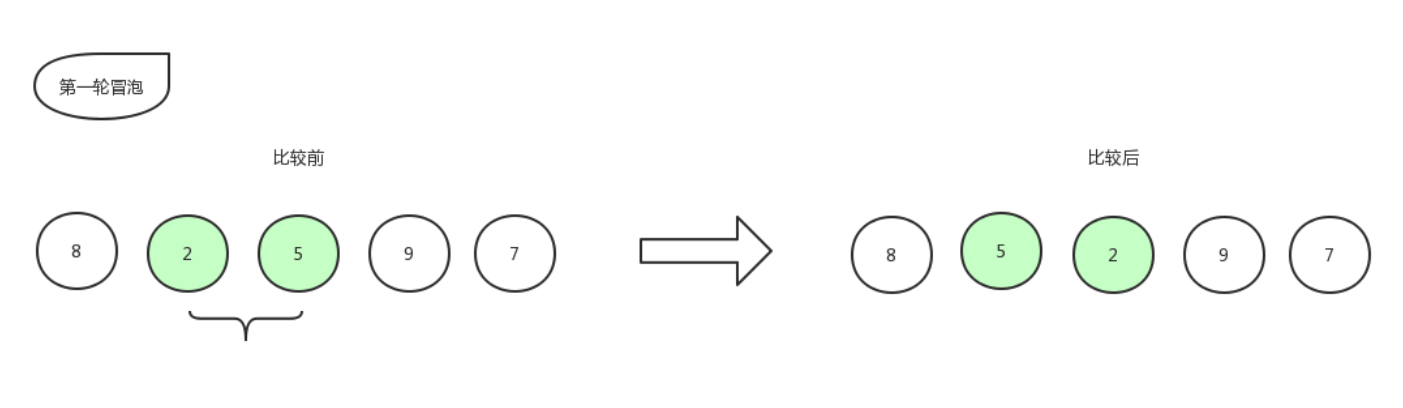
比较第二个数和第三个数的大小,发现 2 比 5 要小,所以位置交换,交换后数组更新为:[ 8,5,2,9,7 ]。

指针再往右移动一格,继续比较:
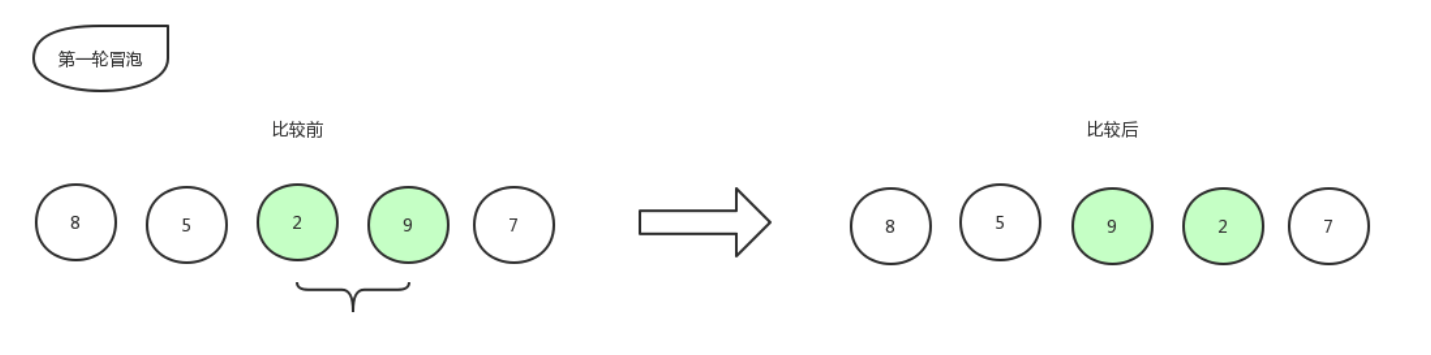
比较第三个数和第四个数的大小,发现 2 比 9 要小,所以位置交换,交换后数组更新为:[ 8,5,9,2,7 ]

同样,指针再往右移动,继续比较:
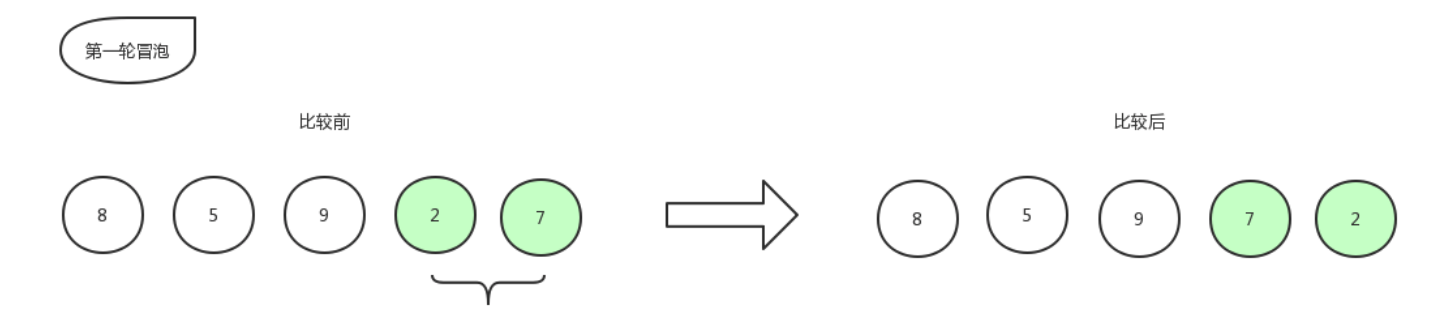
比较第 4 个数和第 5 个数的大小,发现 2 比 7 要小,所以位置交换,交换后数组更新为:[ 8,5,9,7,2 ]

下一步,指针再往右移动,发现已经到底了,则本轮冒泡结束,处于最右边的 2 就是已经排好序的数字。

通过这一轮不断的对比交换,数组中最小的数字移动到了最右边。

第二轮冒泡

接下来继续第二轮冒泡:
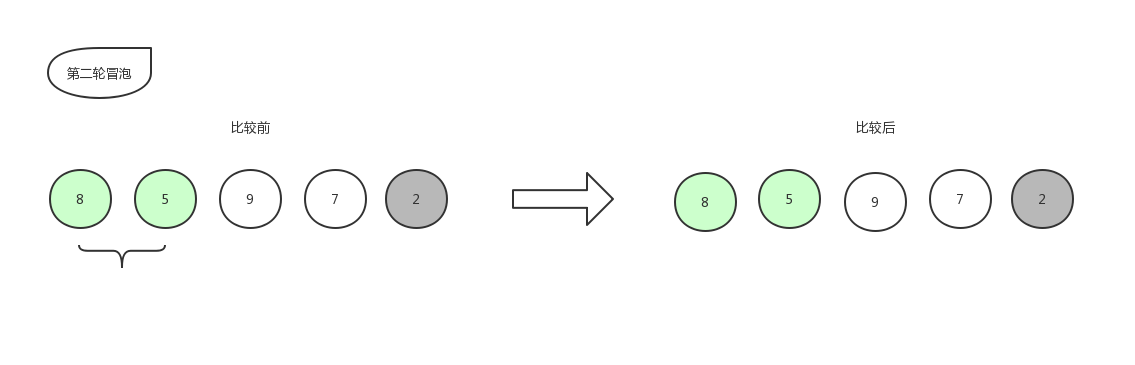
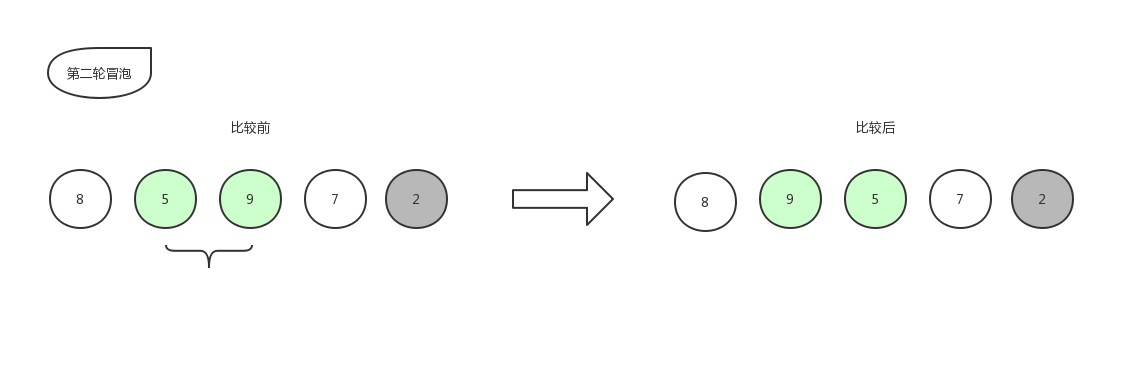
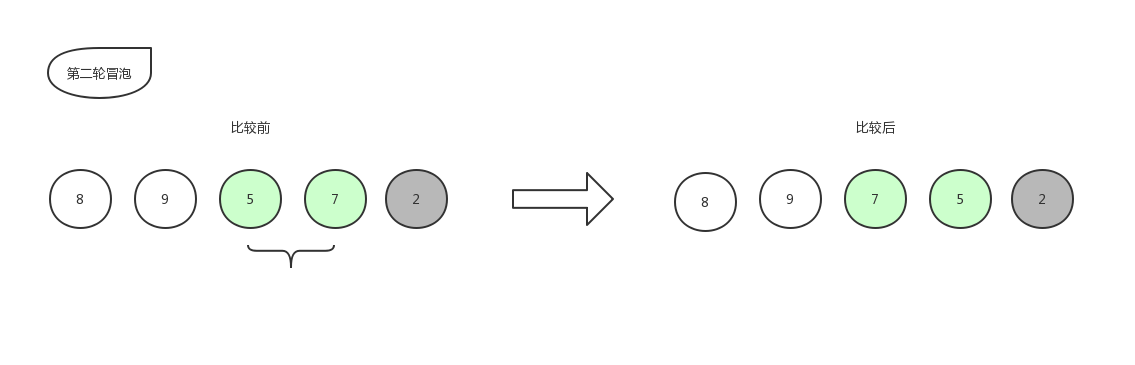
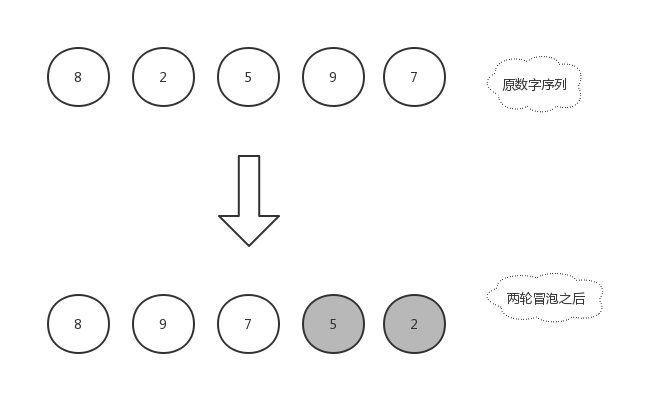
由于右边的 2 已经是排好序的数字,就不再参与比较,所以本轮冒泡结束,本轮冒泡最终冒到顶部的数字 5 也归于有序序列中,现在数组已经变化成了[ 8,9,7,5,2 ]。
第三轮冒泡

让我们开始第三轮冒泡吧!
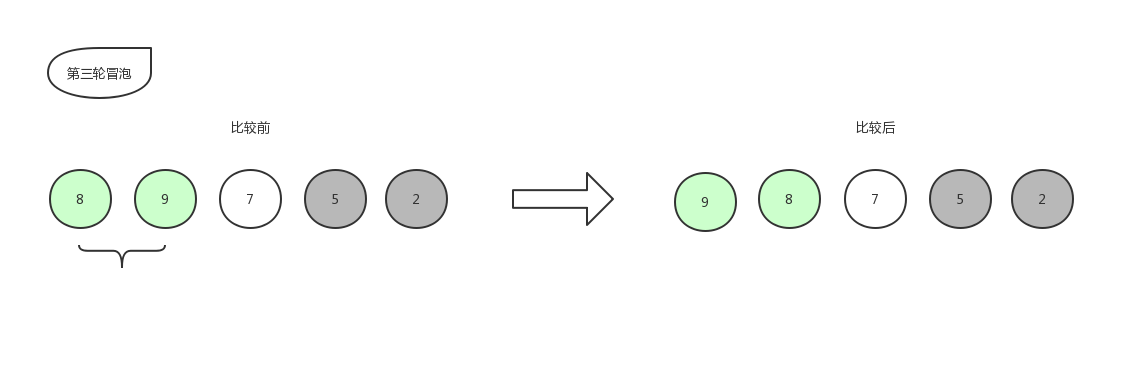
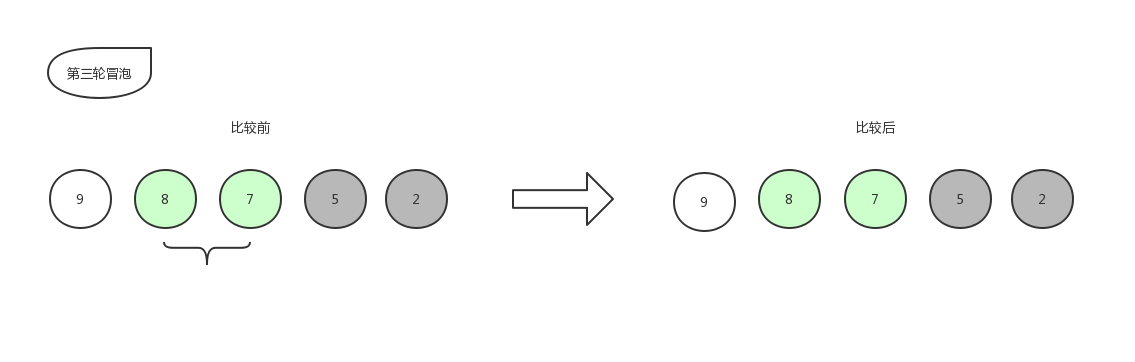
由于 8 比 7 大,所以位置不变,此时第三轮冒泡也已经结束,第三轮冒泡的最后结果是[ 9,8,7,5,2 ]

第四轮冒泡

紧接着第四轮冒泡:
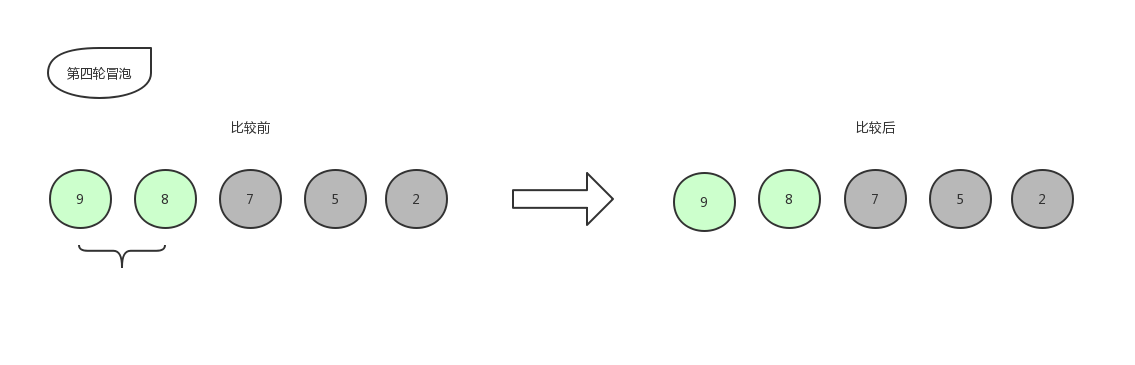
9 和 8 比,位置不变,即确定了 8 进入有序序列,那么最后只剩下一个数字 9 ,放在末尾,自此排序结束。

  ...

【Algorithm】排序算法 - 快速排序(Quick Sort)

快速排序(Quick Sort)

快速排序的核心思想也是分治法(Divide and Conquer Method),分而治之。

它的实现方式是每次从序列中选出一个基准值(pivot),其他数依次和基准值做比较,比基准值大的放右边,比基准值小的放左边,然后再对左边和右边的两组数分别选出一个基准值,进行同样的比较移动,重复步骤,直到最后都变成单个元素,整个数组就成了有序的序列。

  ...


【Interview】应聘者提问

SOA

  • 如何看待SOA
  • 下一个SOA
  ...


【Network】Shadowsocks 总结

Shadowsocks Server

Shadowsocks Server 的实现

  ...


【Data Structure】图(Graph)- 图的物理存储

图的顺序存储方法 - 邻接矩阵(Adjacency Matrix)

使用数组存储图时,需要使用两个数组,一个数组存放图中顶点本身的数据(一维数组),另外一个数组用于存储各顶点之间的关系(二维数组)。

  • 如果只是存储图中包含的顶点,使用一维数组就足够了;
  • 然而,我们还需要存储顶点之间的关系,因此要记录每个顶点和其它所有顶点之间的关系,所以需要使用二维数组。

这个二维数组称为邻接矩阵(Adjacency Matrix)。


不同类型的图,存储的方式略有不同,根据图有无权,可以将图划分为两大类:图和网 。

图,包括无向图和有向图;网,是指带权的图,包括无向网和有向网。


存储方式的不同,指的是:在使用二维数组存储图中顶点之间的关系时,如果顶点之间存在边或弧,在相应位置用 1 表示,反之用 0 表示;如果使用二维数组存储网中顶点之间的关系,顶点之间如果有边或者弧的存在,在数组的相应位置存储其权值;反之用 0 表示。

无向图

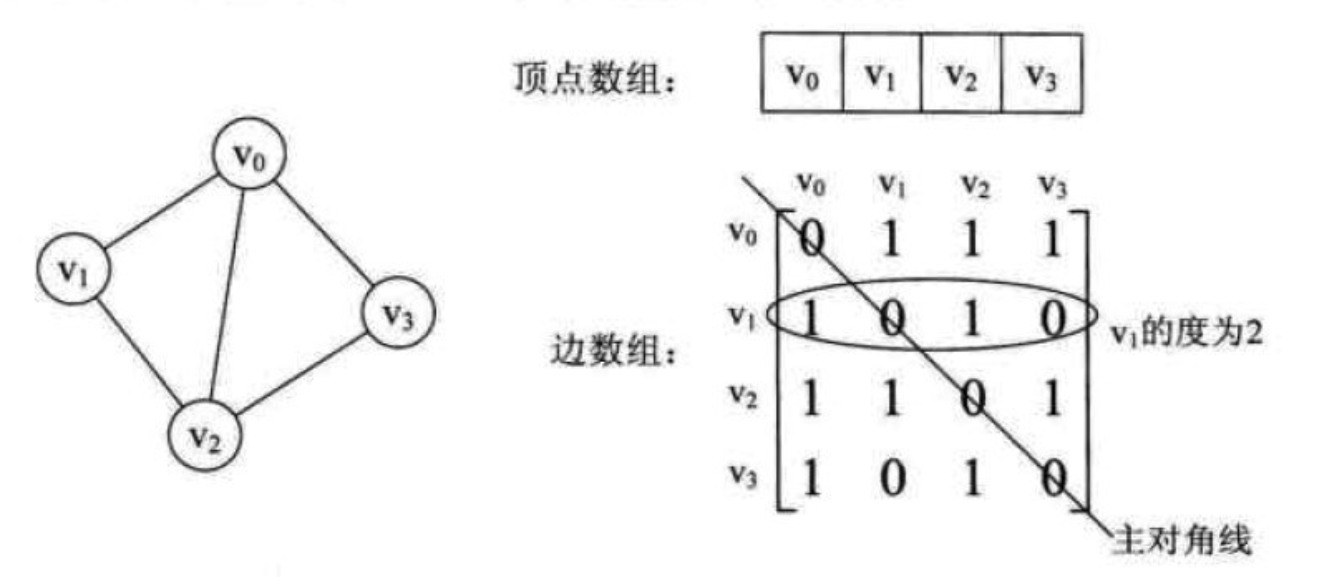
我们来看一个无向图的实例,下图的左图就是一个无向图:

对于无向图来说,二维数组构成的邻接矩阵,实际上是对称矩阵。因此,在存储时就可以采用压缩存储的方式存储下三角或者上三角。

通过二阶矩阵,可以直观地计算出各个顶点的度,为该行(或该列)非 0 值的和。例如,第一行有两个 1,说明 V1 有两个边,所以度为 2。

有向图

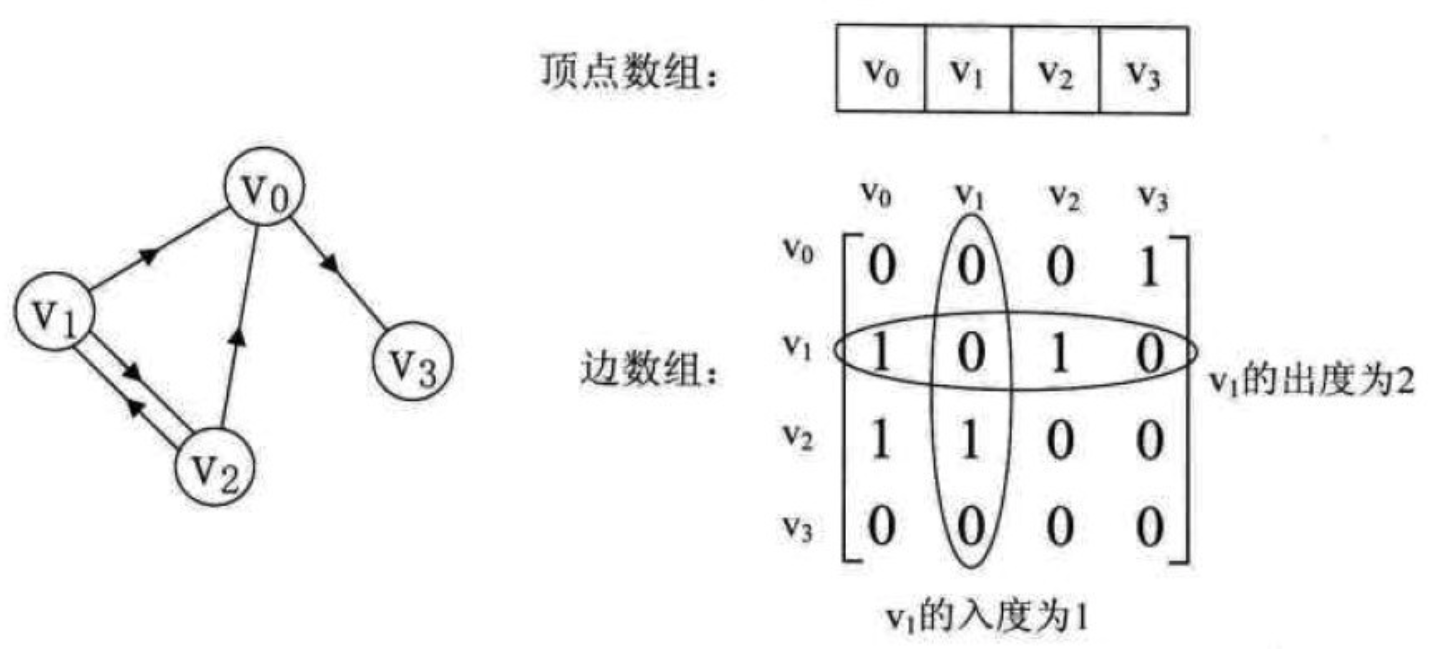
我们再来看一个有向图的样例,如下图所示的左图:

例如,arcs[0][1] = 1 ,证明从 V1 到 V2 有弧存在。且通过邻接矩阵,可以很轻松得知各顶点的出度和入度,出度为该行非 0 值的和,入度为该列非 0 值的和。例如,V1 的出度为 2 (因为第二行中有两个 1 ),为 2 ; V1 的入度为 1 (第二列中只有一个 1 )。

  ...


【Data Structure】图(Graph) - 图的深度优先搜索(Depth First Search)

  ...


【Data Structure】Tries树(字典树)

Trie树

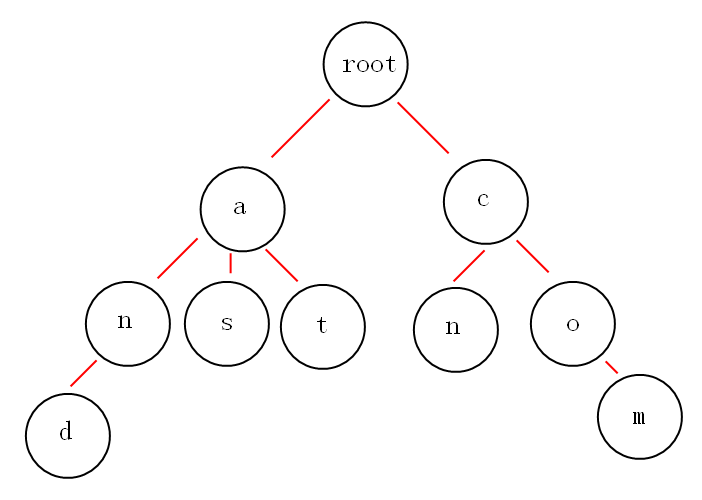
Trie树,又叫字典树、前缀树(Prefix Tree)、单词查找树或键树,是一种多叉树(k-ary search tree)结构。如下图:

  ...


【Database】索引(Index)

索引(Index)

A database index is a data structure that improves the speed of data retrieval operations on a database table at the cost of additional writes and storage space to maintain the index data structure. Indexes are used to quickly locate data without having to search every row in a database table every time a database table is accessed. Indexes can be created using one or more columns of a database table, providing the basis for both rapid random lookups and efficient access of ordered records.

  ...


【Database】索引 - B 树和 B+ 树

背景

  • Binary tree:二叉树(Binary tree),每个节点只能存储一个key
  • B-tree:B树(B-Tree,并不是B“减”树,横杠为连接符,容易被误导)
    • B树属于多叉树,同时也属于平衡多路查找树。每个节点可以包含多个key(包含多少个由磁盘的页的大小决定)。
    • B+tree(B+树) 和 B*tree(B*树) 都是 B-tree 的变种
  ...