于海量数据而言,由于无法一次性装进内存处理,导致我们不得不把海量的数据通过hash映射分割成相应的小块数据,然后再针对各个小块数据通过hashmap进行统计或其它操作。
那什么是hash映射呢?简单来说,就是为了便于计算机在有限的内存中处理大数据,我们通过一种映射散列的方式让数据均匀分布在对应的内存位置(如大数据通过取余的方式映射成小数存放在内存中,或大文件映射成多个小文件),而这个映射散列方式便是我们通常所说的hash函数,设计的好的hash函数能让数据均匀分布而减少冲突。
Posted by Wei on 2019-07-05, Last Modified on 2025-08-11
在大规模数据处理中,经常会遇到的一类问题:在海量数据中找出出现频率最好的前k个数,或者从海量数据中找出最大的前k个数,这类问题通常被称为top K问题。例如,在搜索引擎中,统计搜索最热门的10个查询词;在歌曲库中统计下载最高的前10首歌等。
针对top K类问题,通常比较好的方案是分治+Trie树/hash+小顶堆(就是上面提到的最小堆),即先将数据集按照Hash方法分解成多个小数据集,然后使用Trie树或 Hash 统计每个小数据集中的query词频,之后用小顶堆求出每个数据集中出现频率最高的前K个数,最后在所有top K中求出最终的top K。
10亿int整型数,以及一台可用内存为1GB的机器,时间复杂度要求O(n),统计只出现一次的数?
首先说下最常见的 XSS 漏洞,XSS (Cross Site Script),跨站脚本攻击,因为缩写和 CSS (Cascading Style Sheets) 重叠,所以只能叫 XSS。
XSS 的原理是恶意攻击者往 Web 页面里插入恶意可执行网页脚本代码,当用户浏览该页之时,嵌入其中 Web 里面的脚本代码会被执行,从而可以达到攻击者盗取用户信息或其他侵犯用户安全隐私的目的。XSS 的攻击方式千变万化,但还是可以大致细分为几种类型。
Posted by Wei on 2019-07-04, Last Modified on 2023-01-13
面向对象的三大特性:封装(encapsulation)、继承(Inheritance)和多态(polymorphism)。从一定角度来看,封装和继承几乎都是为多态而准备的。
Posted by Wei on 2019-07-03, Last Modified on 2025-08-11
Posted by Wei on 2019-06-28, Last Modified on 2025-08-11
Fibonacci数(Fibonacci Number)的定义是:F(n) = F(n - 1) + F(n - 2),并且F(0) = 0,F(1) = 1。对于任意指定的整数n(n ≥ 0),计算F(n)的精确值
Posted by Wei on 2019-06-27, Last Modified on 2025-08-11
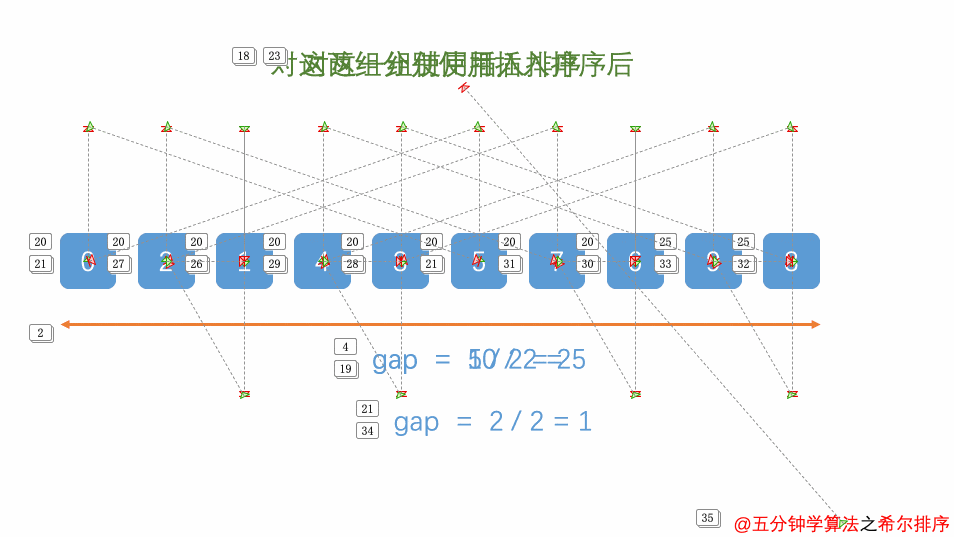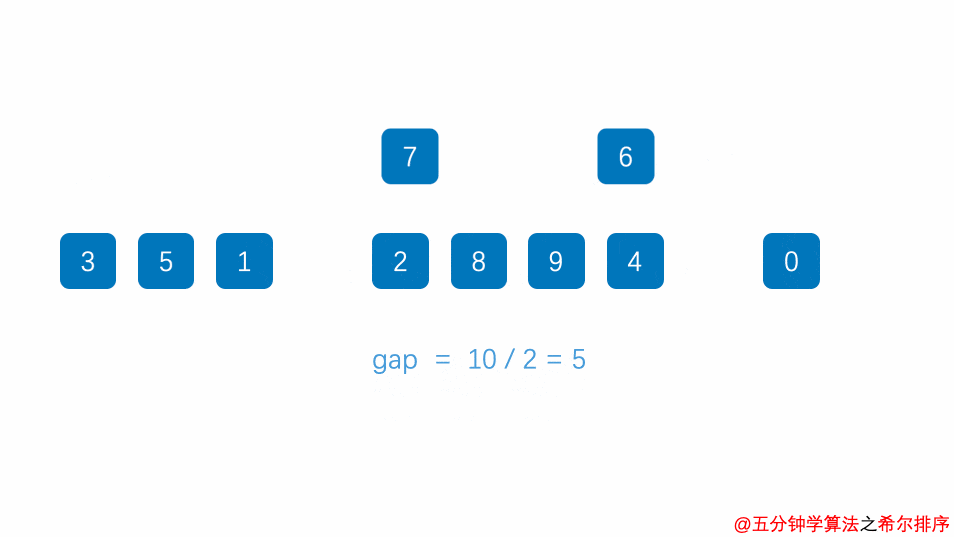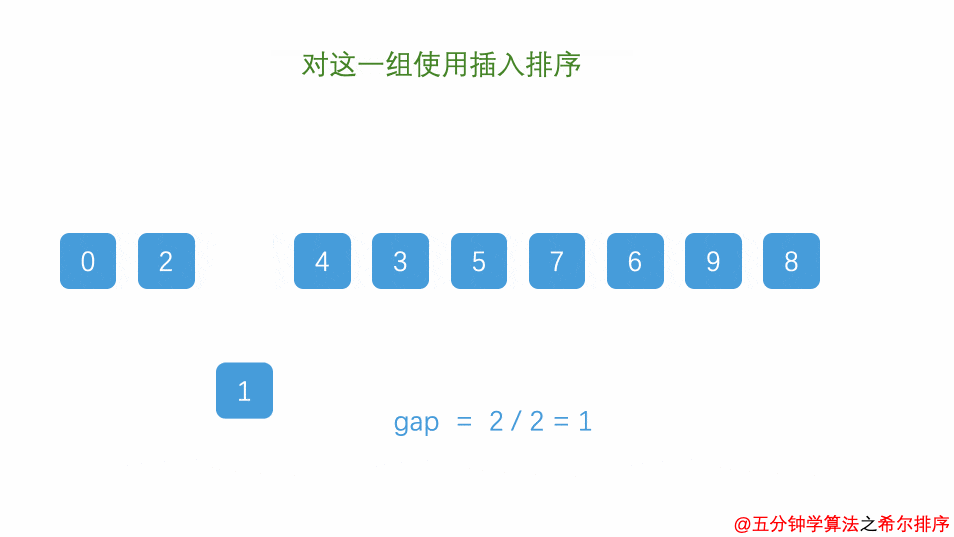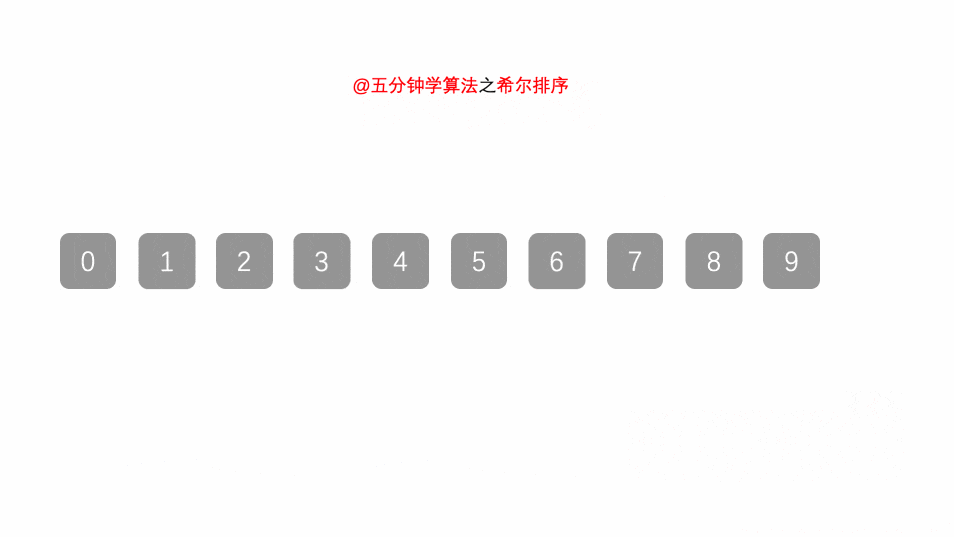
希尔排序(Shell Sort),又Shell在1959年发明,是第一个突破$O(n^2)$的排序算法,是简单插入排序的改进版。它与插入排序的不同之处在于,它会优先比较距离较远的元素。希尔排序又叫缩小增量排序(diminishing increment sort)。
插入排序(Insertion Sort)的一个重要的特点是,如果原始数据的大部分元素已经排序,那么插入排序的速度很快(因为需要移动的元素很少)。从这个事实我们可以想到,如果原始数据只有很少元素,那么排序的速度也很快。
希尔排序就是基于这两点对插入排序作出了改进。
Posted by Wei on 2019-06-26, Last Modified on 2025-08-11
插入排序(Insertion-Sort)是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
插入排序的思想和我们打扑克摸牌的时候一样,从牌堆里一张一张摸起来的牌都是乱序的,我们会把摸起来的牌插入到左手中合适的位置,让左手中的牌时刻保持一个有序的状态。
那如果我们不是从牌堆里摸牌,而是左手里面初始化就是一堆乱牌呢? 一样的道理,我们把乱序的牌往手的右边挪一挪,把手的左边空出一点位置来,然后在乱牌中抽一张出来,插入到左边,再抽一张出来,插入到左边,再抽一张,插入到左边,每次插入都插入到左边合适的位置,时刻保持左边的牌是有序的,直到右边的牌抽完,则排序完毕。
Posted by Wei on 2019-06-25, Last Modified on 2025-08-11
🐒 Software engineer | 📷 Photographer | 👹 Urban explorer