西维蜀黍

【Data Structure】串(String)

串(String)

**串的基本概念:**串是由零个或多个任意字符组成的字符序列。

一般记作:s=‘a1 a2 an’。

  ...


【Data Structure】队列(Queue)

队列(Queue)

通常,称进数据的一端为 “队尾”(rear),出数据的一端为 “队头”(top),数据元素进队列的过程称为 “入队(enqueue)",出队列的过程称为 “出队(dequeue)"。

  ...


【Data Structure】栈的应用

栈的应用

栈是一种很重要的数据结构,在计算机中有着很广泛的应用,如下一些操作都应用到了栈。

  • 符号匹配,HTML和XML文件中的标签匹配
  • 中缀表达式(Infix Expressions)转换为后缀表达式(Postfix Expressions)
  • 实现函数的嵌套调用
  • 表达式求值
  • 网页浏览器中已访问页面的历史记录
  ...


【Java】集合类 - Stack

Stack 类是Vector类的一个子类,它通过数组实现了一个标准的后进先出的栈。

构造函数

Stack 的实现非常简单,仅有一个构造方法。

public Stack() {
}

方法

除了由Vector定义的所有方法,自己也定义了一些方法:

序号 方法描述
1 boolean empty() 测试堆栈是否为空。
2 Object peek( ) 查看堆栈顶部的对象,但不从堆栈中移除它。
3 Object pop( ) 移除堆栈顶部的对象,并作为此函数的值返回该对象。
4 Object push(Object element) 把项压入堆栈顶部。
5 int search(Object element) 返回对象在堆栈中的位置,以 1 为基数。

public boolean empty()

返回栈是否为空。

public boolean empty() {
    return size() == 0;
}
  ...


【Data Structure】栈(Stack)

栈(Stack)

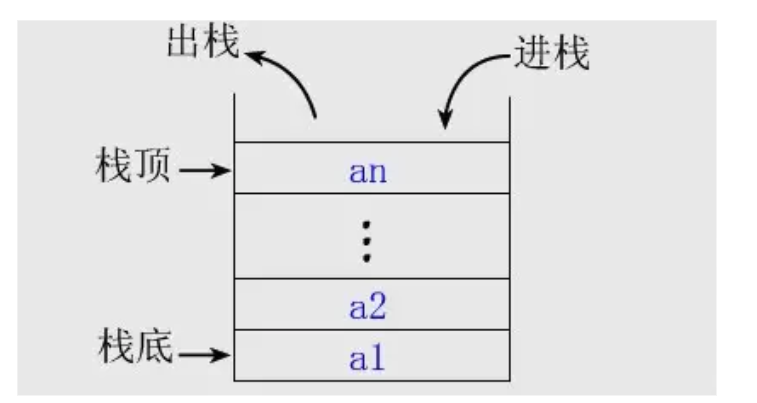
栈(Stack),是一种有序特殊的线性表,只允许在有序的线性数据集合的一端(称为堆栈顶端,top)进行加入(push)数据和移除(pop)数据的运算。因而按照**后进先出(LIFO, Last In First Out)**的原理运作。

栈的基本操作创建栈,判空,入栈,出栈,获取栈顶元素等,注意栈不支持对指定位置进行删除,插入。

其实非常好理解,我们将栈可以看成一个箱子:

  • 往箱子里面放东西叫做入栈(push);
  • 往箱子里面取东西叫做出栈(pop);
  • 箱子的底部叫做栈底(bottom);
  • 箱子的顶部叫做栈顶(top)。

说到栈的特性,肯定会有一句经典的言语来概括:先进后出(LIFO, Last In First Out)。

Stack这种数据结构用途很广泛,在计算机的使用中,大量的运用了栈,比如编译器中的词法分析器、Java虚拟机、软件中的撤销操作(Undo)、浏览器中的回退操作,编译器中的函数调用实现等等。

  ...


【Java】运算符-位运算符

基础

我们已经知道计算机中,所有数据最终都是使用二进制数表达。

比如,假设有一 int 类型的数,值为5,那么,我们知道它在计算机中表示为:00000000 00000000 00000000 00000101 5转换成二制是101,不过int类型的数占用4字节(32位),所以前面填了一堆0。 现在想知道,-5在计算机中如何表示?

在计算机中,负数以其正值的补码形式表达。

  ...


【Data Structure】链表 - 循环链表(Circular Linked List)

循环链表(Circular Linked List)

双链表就是在单链表结点上增添了一个指针域,指向当前结点的前驱。这样就可以方便的由其后继来找到其前驱,而实现输出终端结点到开始结点的数据序列。

同样,双链表也分为带头结点的双链表和不带头结点的双链表,情况类似于单链表。带头结点的双链表 head->next 为null的时候链表为空。不带头结点的双链表head为null的时候链表为空。

  ...


【Data Structure】链表 - 双向链表(Doubly Linked List)

双向链表(Doubly Linked List)

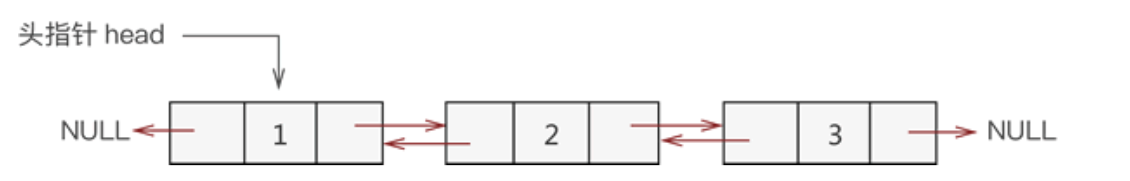
从名字上理解双向链表(Doubly Linked List),即链表是 “双向” 的,如下图所示:

  ...


【Java】集合类 - List - LinkedList

LinkedList

LinkedList 和 ArrayList 一样,都实现了 List 接口,但其内部的数据结构有本质的不同。LinkedList 是基于链表实现的(通过名字也能区分开来),所以它的插入和删除操作比 ArrayList 更加高效。但也是由于其为基于链表的,所以随机访问的效率要比 ArrayList 差。

  ...


【Data Structure】链表(Linked List)

链表(Linked List)

链表(Linked List),别名链式存储结构或单链表,用于存储逻辑关系为 “一对一” 的数据。与顺序表不同,链表不限制数据的物理存储状态,换句话说,使用链表存储的数据元素,其物理存储位置是随机的。

例如,使用链表存储 {1,2,3},数据的物理存储状态如下图所示:
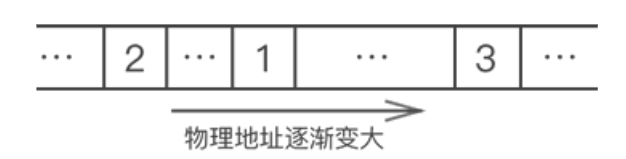
我们看到,上图根本无法体现出各数据之间的逻辑关系。对此,链表的解决方案是,每个数据元素在存储时都配备一个指针,用于指向自己的直接后继元素。如下图所示:
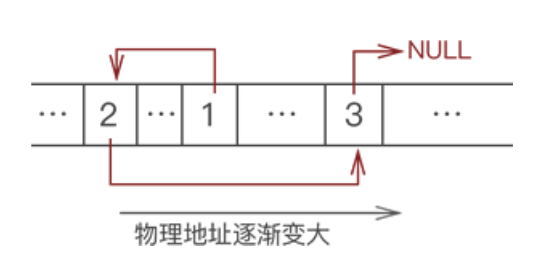
像上图这样,数据元素随机存储,并通过指针表示数据之间逻辑关系的存储结构就是链式存储结构。

也就是说:链表具有动态的能力,不需要去处理固定容量的问题

正因为链表具备这种动态能力,那它也就缺失了**高效的random access(随机访问)**的能力。它无法与数组一样,通过一个索引(index)直接获取对应的元素。

因为在底层机制中数组开辟的空间在内存中是连续分布的,我们可以直接寻找索引对应的偏移,直接计算出数据所存储的内存地址,直接用O(1)复杂度拿出。

链表靠next连接,每个节点存储地址不同,我们只能通过next顺藤摸瓜找到我们要找的元素。

  ...